Google Leak: i documenti trapelati sugli algoritmi riassunti in italiano
Capitolo 8 di 9 della guida Come funziona Google
NavBoost, siteAuthority, clic e Chrome nei 14.014 attributi trapelati, cosa non dicono e cosa cambia. Scarica il riassunto in italiano.
Fondatore di SEO SRL
Pubblicato il Aggiornato il 8 min di lettura1.696 parole

Il Google Leak è la diffusione, nel maggio 2024, di documentazione interna della Ricerca Google: oltre 2.500 pagine che descrivono 14.014 attributi usati dai suoi sistemi, senza i pesi del ranking.
Indice dei contenuti (8 sezioni)
A fine maggio 2024 è diventata pubblica una parte della documentazione interna della Ricerca Google: più di 2.500 pagine che descrivono 14.014 attributi delle API del “Content Warehouse”, l’archivio in cui i sistemi di Google conservano e valutano le informazioni sulle pagine. I file erano finiti per errore su un repository GitHub a marzo 2024 e sono stati rimossi il 7 maggio; il 27 maggio Rand Fishkin ne ha raccontato la scoperta sul blog di SparkToro.
A fine maggio Google ha confermato che alcuni dei file sono autentici, invitando però a non trarre conclusioni sulla Ricerca da informazioni “fuori contesto, datate o incomplete”. Sotto trovi cosa contengono i documenti, cosa non dicono e il riassunto in italiano da scaricare.
Il Google Leak in breve
| Domanda | Risposta |
|---|---|
| Cosa è trapelato | La documentazione delle API interne del Content Warehouse: 2.596 moduli e 14.014 attributi, secondo il conteggio di Mike King (iPullRank). Non il codice, non le formule di ranking. |
| Come | I file sono stati caricati per errore in un repository pubblico su GitHub il 27 marzo 2024 e tolti il 7 maggio. Nel frattempo erano stati copiati da servizi che indicizzano la documentazione del codice. |
| Chi l’ha diffuso | Erfan Azimi, consulente SEO, li ha passati a Rand Fishkin. Fishkin e King li hanno pubblicati e analizzati il 27 maggio 2024. |
| Sono autentici? | In parte. A fine maggio 2024 Google ha confermato che alcuni file sono autentici, avvertendo che possono essere fuori contesto, datati o incompleti. |
| Cosa manca | I pesi. Sappiamo che un attributo esiste, non quanto conta né se è ancora usato. |
Un attributo è un campo di dati: un nome tecnico con una breve descrizione, per esempio “quanto il titolo corrisponde alla ricerca”. Un modulo è un gruppo di attributi che riguarda lo stesso oggetto (una pagina, un sito, un link). Leggere il leak è come leggere l’indice di un magazzino: sai cosa viene conservato e come si chiama, non come viene usato.
Cosa c’è nei documenti: gli attributi più discussi
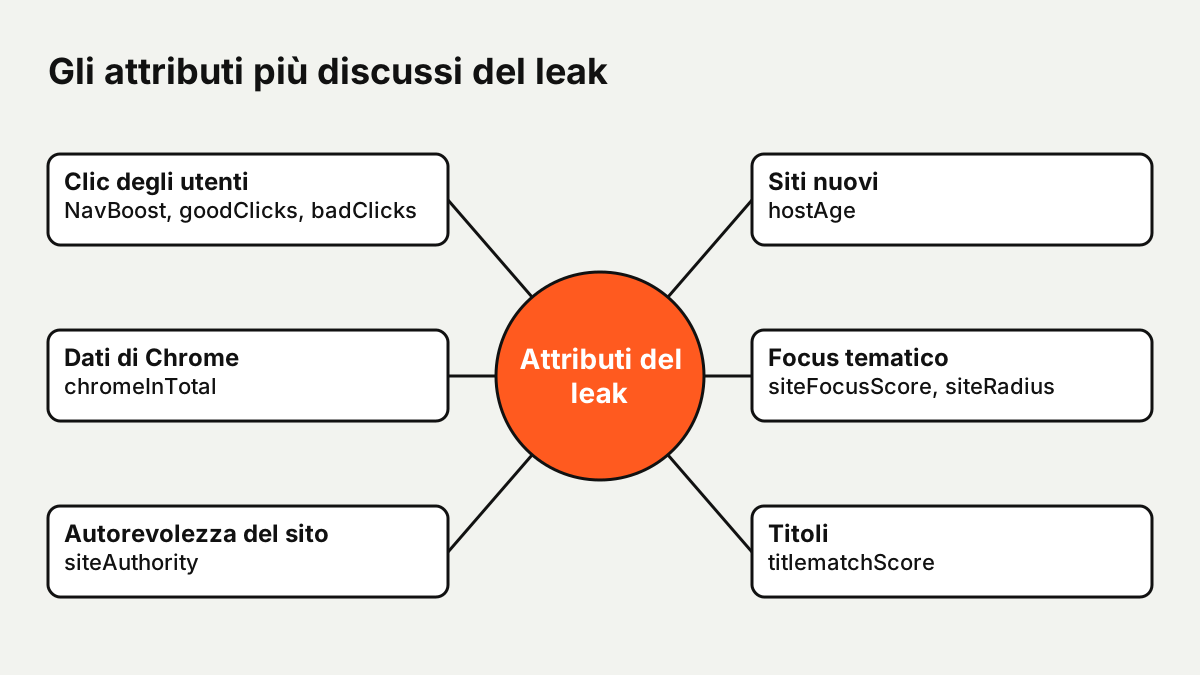
I documenti descrivono cosa viene registrato di una pagina, di un sito, dei link e del comportamento degli utenti. Sono i punti che hanno fatto più rumore, con il nome dell’attributo come compare nei file. Per il quadro generale di come lavorano questi sistemi c’è la guida su come funziona davvero Google.
| Tema | Attributi o moduli | Cosa descrivono |
|---|---|---|
| Clic degli utenti | NavBoost, goodClicks, badClicks, lastLongestClicks | Segnali basati su clic e impressioni: clic “buoni” e “cattivi”, il clic più lungo di una ricerca. NavBoost è citato 84 volte e ha cinque moduli con il suo nome. |
| Dati di Chrome | chromeInTotal | Visualizzazioni a livello di sito raccolte da Chrome. Fishkin cita anche l’uso dei dati di navigazione per scegliere gli URL dei sitelink. |
| Autorevolezza del sito | siteAuthority | Un valore di autorità a livello di sito, conservato tra i segnali di qualità compressi. |
| Siti nuovi | hostAge | Età dell’host, usata secondo la descrizione per “mettere in sandbox lo spam nuovo”. |
| Declassamenti | Panda, anchor mismatch, exact match domain, product review, location, porn | Penalizzazioni applicate dopo il primo ordinamento: contenuti di bassa qualità, testo dei link incoerente con la pagina, domini a corrispondenza esatta, recensioni deboli. |
| Riordino dei risultati | Twiddler | Funzioni che correggono la classifica dopo il primo calcolo, per esempio NavBoost, QualityBoost e RealTimeBoost. |
| Link | sourceType, phraseAnchorSpamDays | Link classificati in tre livelli di qualità; picchi sospetti di anchor text di spam. |
| Focus tematico | siteFocusScore, siteRadius | Quanto un sito è concentrato su un argomento e quanto ogni pagina si allontana dal tema medio del sito. |
| Titoli | titlematchScore | Quanto il titolo corrisponde alle ricerche degli utenti. |
| Date | bylineDate, syntacticDate, semanticDate | La data dichiarata in pagina, quella ricavata da URL o titolo e quella stimata dal contenuto. |
| Autori | author, isAuthor | Gli autori di un documento e se un’entità è l’autore. |
| Piccoli siti | smallPersonalSite | Un punteggio per la “promozione dei piccoli siti personali”. Non si sa in che direzione venga usato. |
| Valutatori umani | EWOK, golden | Dati dei quality rater e documenti di riferimento etichettati a mano, usati almeno nei processi di valutazione. |
| Temi delicati | Flag per COVID, elezioni, viaggi | Riferimenti a elenchi di siti per ricerche sensibili. |
Due dettagli si collegano ad altri articoli di questo blog. Il declassamento chiamato Panda conferma che i criteri del vecchio Google Panda continuano a vivere dentro i sistemi principali. E gli attributi sugli anchor text di spam sono la versione moderna di quello che faceva Google Penguin.
Le smentite di Google messe alla prova
Il leak ha fatto rumore soprattutto perché alcuni attributi sembrano in contrasto con ciò che Google aveva detto in pubblico negli anni. I casi più discussi sono quattro.
| Cosa diceva Google | Cosa compare nei documenti | Come la leggo io |
|---|---|---|
| I clic non sono usati per il ranking | NavBoost e gli attributi sui clic buoni e cattivi | NavBoost era già emerso nel processo antitrust negli Stati Uniti (ne parla la scheda su NavBoost e i segnali degli utenti). I clic servono a riordinare i risultati, non a premiare chi ne raccoglie di più a qualunque costo. |
| Non esiste una “domain authority” | siteAuthority | Google non usa la metrica di uno strumento esterno, ma un valore di sito esiste. Le due cose sono compatibili. |
| Non c’è una sandbox per i siti nuovi | hostAge, usato contro lo spam nuovo | Non prova una sandbox per tutti i siti nuovi. Prova un trattamento prudente dei domini giovani sospetti. |
| I dati di Chrome non servono al ranking | chromeInTotal e dati di navigazione per i sitelink | È il punto meno chiaro. Il dato viene raccolto; come pesa non lo sappiamo. |
Per me il punto è questo: molte dichiarazioni di Google erano formulate con prudenza, e i documenti da soli non dicono se fossero false o solo incomplete. La lezione è di metodo: le dichiarazioni ufficiali sono un punto di partenza, poi servono i test.
Cosa i documenti non dicono
Sul leak si sono sentite molte esagerazioni. I limiti li hanno messi in chiaro gli stessi autori delle prime analisi:
- Nessun peso. Non c’è scritto quanto conta un attributo rispetto a un altro. Una lista di 14.014 campi non è una lista di 14.014 fattori di ranking.
- Nessuna garanzia di uso. Alcuni attributi possono essere deprecati, usati solo per test o mai usati.
- Nessun codice. È documentazione di API, con rimandi a pagine interne che da fuori non si possono aprire.
- Una fotografia datata. I documenti descrivono la Ricerca com’era prima del maggio 2024. Da allora Google ha rilasciato diversi aggiornamenti principali e ha portato l’AI in SERP.
Fishkin stesso li presenta come un’indicazione forte, non una prova. Chi ti vende “il fattore segreto del leak” sta vendendo un’interpretazione.
Cosa cambia in pratica per la SEO
I documenti non dimostrano quanto pesi ciascun attributo né che sia ancora in uso, quindi qui non trovi regole ma ipotesi di lavoro, che sono la mia lettura. Per ciascuna c’è l’attributo da cui nasce:
- Title coerente con la ricerca. Esiste un attributo, titlematchScore, che misura la corrispondenza tra titolo e query. Non sappiamo quanto conti, ma scrivere un title che contenga il tema della ricerca non costa niente.
- Pagina che chiude la ricerca. I documenti registrano clic buoni, clic cattivi e il clic più lungo. Come vengano usati non è detto: è un buon motivo per mettere la risposta nelle prime righe.
- Tema del sito chiaro. siteFocusScore e siteRadius suggeriscono che la coerenza tematica venga misurata. L’ipotesi è che pubblicare articoli scollegati per prendere traffico non aiuti.
- Brand. Fishkin dà molto peso a questo punto nella sua analisi. È una sua interpretazione: i documenti non misurano quanto il brand incida sul ranking.
- Link. I documenti parlano di livelli di qualità dei link e di anchor di spam. Se questo significhi che un link da una pagina senza visite valga poco, non è dimostrato.
- Date coerenti. Esistono tre date per pagina (dichiarata, da URL, stimata dal contenuto). Che vengano confrontate è plausibile, e in ogni caso cambiare la data senza aggiornare davvero la pagina non serve: Google lo sconsiglia nella guida sui contenuti utili.
- Autori dichiarati. Gli attributi sugli autori esistono. Firmare con nome vero e pagina autore costa poco, ma il leak non prova che sia un fattore di ranking.
Nessuno di questi punti è una scoperta: sono cose che Google chiede da anni a chi lavora per le persone. Il leak aggiunge i nomi tecnici, non le prove.
Dopo il leak: AI Overview e AI Mode
Le analisi pubblicate dei documenti non riportano riferimenti a AI Overview né ad AI Mode, quindi non dicono nulla su come funzionino. Per lo stato attuale vale la pagina di Google sulle funzioni di AI nella Ricerca: per comparire come link di supporto in AI Overview e AI Mode una pagina deve essere indicizzata e idonea a mostrare uno snippet, senza requisiti tecnici aggiuntivi. Le due funzioni usano il “fan-out delle query”, cioè inviano più ricerche correlate in contemporanea. Il traffico che arriva da lì è contato nel report sul rendimento di Search Console, nel tipo di ricerca “Web”.
Il riassunto dei moduli, tradotto in italiano
Nel riassunto che ho preparato trovi i moduli presenti nei documenti. Molti compaiono più volte, in documenti e con funzioni diverse: per questo accanto al nome di ogni modulo trovi la densità di occorrenze, cioè quante volte compare nei documenti trapelati. Ho tradotto in italiano le descrizioni dei moduli, così puoi leggerle senza passare per l’inglese tecnico della documentazione originale.
Scarica il riassunto in italiano dei Google Leaks
Il documento è molto grande, quindi l’ho diviso in più fogli, tutti raggiungibili dal link qui sopra.
Come leggere il riassunto
- Il titolo è il nome del modulo usato dagli sviluppatori; tra parentesi c’è il numero di documenti trapelati in cui compare.
- Subito dopo trovi la descrizione del modulo intero, cioè a cosa serve.
- Infine c’è la descrizione di ogni singolo elemento del modulo e della funzione che svolge.
Un consiglio: cerca nel foglio i nomi della tabella qui sopra (NavBoost, siteAuthority, titlematchScore) e leggi le descrizioni complete. Ti fai un’idea tua invece di fidarti dei titoli dei giornali. Se sei all’inizio e vuoi prima le basi, parti dalla guida su cos’è la SEO.
Se vuoi una prima lettura del tuo sito, puoi richiedere l’audit SEO.
Domande frequenti
Cos'è NavBoost?
È un sistema di Google che usa i dati di clic e impressioni per riordinare i risultati. Nei documenti trapelati è citato 84 volte, insieme ad attributi come goodClicks, badClicks e lastLongestClicks. Secondo la testimonianza di Pandu Nayak al processo antitrust, i dati di clic vengono valutati su un periodo di 13 mesi.
