Server proxy: cos'è, come funziona e a cosa serve
Capitolo 6 di 13 della guida SEO tecnica
Proxy di inoltro e reverse proxy, tipi, differenze con la VPN e cosa fare se CDN e firewall bloccano Googlebot. Leggi la guida.
Fondatore di SEO SRL
Pubblicato il Aggiornato il 7 min di lettura1.346 parole

Un server proxy è un server che fa da intermediario tra un dispositivo e i siti web: il proxy di inoltro nasconde ai siti l'IP di chi naviga, il reverse proxy riceve i visitatori al posto del server di un sito.
Indice dei contenuti (8 sezioni)
- Cos’è un server proxy e come funziona
- Proxy di inoltro e reverse proxy: le differenze
- I tipi di proxy
- A cosa serve davvero un proxy, e cosa non fa
- Proxy e VPN: le differenze
- Reverse proxy, CDN e SEO: quando il proxy blocca Googlebot
- Proxy e SEO: controllare i risultati in altri paesi
- Checklist per chi ha un sito dietro proxy o CDN
Un server proxy è un server che si mette in mezzo tra un dispositivo e i siti web e inoltra le richieste al posto di uno dei due. Il proxy usato da chi naviga fa vedere ai siti il suo indirizzo IP al posto del tuo; il reverse proxy usato da chi ha un sito riceve i visitatori al posto del server vero e lo protegge.
Sono due strumenti diversi con lo stesso nome. Li spiego entrambi, con più spazio a ciò che serve a chi ha un sito: cosa succede alla SEO quando il proxy davanti al sito blocca Googlebot.
Cos’è un server proxy e come funziona
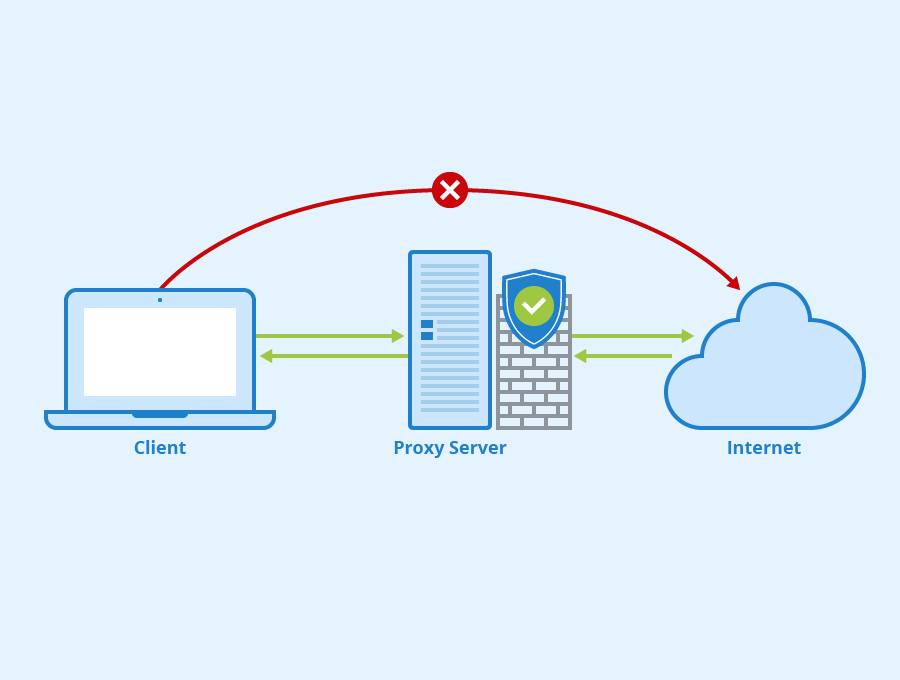
Senza proxy, il browser si collega direttamente al server del sito (dopo che il server DNS ha tradotto il nome in indirizzo IP). Con un proxy, il percorso diventa:
- il browser manda la richiesta al proxy;
- il proxy la inoltra al sito, con il proprio indirizzo IP;
- il sito risponde al proxy;
- il proxy passa la risposta al browser, a volte dopo averla filtrata o salvata in cache.
Il sito vede l’IP del proxy, non il tuo. Il proxy, invece, vede quali siti visiti e, se la connessione non è cifrata, anche i contenuti. Il proxy non aggiunge nessuna cifratura. Con i siti in HTTPS apre un tunnel (metodo CONNECT) e la cifratura resta quella tra il browser e il sito: il proxy sa dove vai, ma non cosa leggi o scrivi.
Proxy di inoltro e reverse proxy: le differenze
| Proxy di inoltro (forward proxy) | Reverse proxy | |
|---|---|---|
| Dove sta | Davanti a chi naviga | Davanti ai server di un sito |
| Lavora per | L’utente o l’azienda | Il sito |
| Cosa nasconde | L’IP di chi naviga | L’IP del server di origine |
| A cosa serve | Filtri e regole in azienda o a scuola, cambiare l’IP visto dai siti, cache locale | Bilanciamento del carico, cache, HTTPS, protezione da attacchi e bot |
| Esempi | Proxy aziendale, servizi proxy a pagamento | CDN, firewall per applicazioni web, Nginx davanti a un’applicazione |
Se gestisci un sito, il reverse proxy probabilmente ce l’hai già, anche senza saperlo: molte CDN e molti hosting funzionano proprio così.
I tipi di proxy
Per i proxy di inoltro si usano parecchie etichette, spesso più di marketing che tecniche. Le distinzioni che contano davvero sono queste:
| Tipo | Cosa fa |
|---|---|
| HTTP/HTTPS | Gestisce solo il traffico web |
| SOCKS (SOCKS5) | Inoltra anche altri tipi di traffico, non solo web |
| Web proxy | Un sito in cui scrivi l’indirizzo da visitare; nessuna configurazione, molta pubblicità e privacy discutibile |
A cosa serve davvero un proxy, e cosa non fa
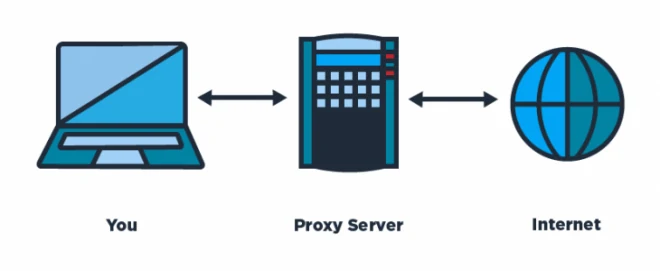
Per chi naviga, un proxy di inoltro serve a:
- mostrare ai siti un IP diverso dal tuo, anche di un altro paese;
- applicare regole comuni in un’azienda o in una scuola: siti bloccati, registrazione degli accessi, cache condivisa;
- passare da una rete che lo richiede, come alcune reti aziendali o universitarie.
Quello che un proxy non fa, anche se molti siti lo promettono:
- Non aggiunge cifratura. Su un Wi-Fi pubblico non ti protegge come una VPN; i siti in HTTPS restano cifrati per conto loro.
- Non ti rende anonimo verso chi gestisce il proxy, che vede i siti che visiti. Un proxy gratuito di sconosciuti è una scelta rischiosa per la tua navigazione: qualcuno quel servizio lo paga, e spesso con i tuoi dati.
- Non velocizza la connessione. Un proxy lontano o sovraccarico la rallenta. La cache aiuta solo se molte persone visitano le stesse pagine, come in un ufficio.
In Italia l’uso di un proxy non è di per sé vietato. Resta illecito ciò che lo sarebbe anche senza proxy: aggirare un blocco disposto per legge, per esempio, resta una violazione.
Proxy e VPN: le differenze
Entrambi fanno passare il traffico da un server intermedio e cambiano l’IP che vedono i siti. Le somiglianze finiscono qui.
| Proxy | VPN | |
|---|---|---|
| Cifratura | Nessuna aggiunta: i siti in HTTPS restano cifrati da soli | Sì, tra il dispositivo e il server VPN |
| Traffico coperto | Solo le app che usano il proxy (di solito il browser) | Tutto il traffico del dispositivo |
| Velocità | Dipende dal proxy; niente costo di cifratura | Un po’ più lenta, per il percorso e la cifratura |
| Uso tipico | Filtri aziendali, IP diverso per il web | Riservatezza su reti non fidate, lavoro da remoto |
In entrambi i casi il gestore del servizio vede il traffico in uscita, quindi va scelto con attenzione.
Reverse proxy, CDN e SEO: quando il proxy blocca Googlebot
Per chi ha un sito questa è la parte che conta. Un reverse proxy o una CDN davanti al sito sono quasi sempre una buona idea: nascondono il server di origine, assorbono i picchi di traffico, servono le pagine dalla cache più vicina al visitatore. Aiutano anche la scansione: quando Google rileva che il sito è dietro una CDN, alza la soglia oltre la quale rallenta la scansione, perché presume che il server regga più richieste insieme.
Il rovescio della medaglia: le protezioni contro i bot e gli attacchi a volte bloccano proprio i bot che vuoi. Questi blocchi hanno conseguenze molto diverse a seconda di cosa riceve Googlebot.
| Cosa riceve Googlebot | Effetto | Cosa fare |
|---|---|---|
| Codice 503 | Segnale di blocco temporaneo: ti lascia il tempo di correggere | È la risposta da preferire per i blocchi temporanei |
| Timeout di rete | Errore “duro”: Google lo tratta come un 5xx, la scansione rallenta e gli URL già indicizzati e irraggiungibili vengono rimossi in pochi giorni | Controllare le regole del firewall con il fornitore |
| Pagina di errore con codice 200 | Il caso peggiore: gli URL possono essere rimossi o trattati come duplicati, e il recupero è lento | Mai rispondere 200 a una pagina di errore |
| Pagina “sei un umano?” | Googlebot vede solo la verifica, non il sito | Ai crawler va restituito un 503, non la pagina di verifica |
Come accorgersene: con il Controllo URL di Search Console guarda lo screenshot della pagina sottoposta a rendering. Se vedi la pagina, tutto bene; se vedi una pagina vuota, un errore o una richiesta di verifica, parla con il fornitore della CDN. Google pubblica gli indirizzi IP dei suoi crawler, come spiega la pagina su come verificare Googlebot, proprio per permetterti di toglierli dalle regole di blocco o di metterli in una lista di eccezioni. Lo stesso vale per i crawler dei sistemi di intelligenza artificiale: firewall e CDN possono bloccarli anche con il robots.txt aperto, come spiego nella guida a GPTBot.
Un consiglio pratico: quando attivi una CDN o cambi le regole del firewall, segnati la data e guarda per qualche settimana le Statistiche di scansione di Search Console. Un calo improvviso delle richieste di scansione, o un aumento delle risposte di errore, è il primo segnale che qualcosa sta fermando Googlebot.
Proxy e SEO: controllare i risultati in altri paesi
Chi lavora su siti per più mercati usa spesso proxy o VPN per vedere i risultati di Google come li vede un utente di un altro paese. Per un controllo manuale ogni tanto va bene. Interrogare Google in automatico in massa, magari ruotando proxy, è un’altra cosa: le norme di Google vietano l’invio di query automatiche, compreso lo scraping dei risultati per controllare il posizionamento. Per monitorare le posizioni nel tempo i dati di Search Console bastano quasi sempre, e sono quelli veri.
Checklist per chi ha un sito dietro proxy o CDN
- Il Controllo URL di Search Console mostra la pagina vera, non una verifica anti-bot o una pagina vuota.
- Le regole del firewall non bloccano gli IP ufficiali di Googlebot e degli altri crawler che vuoi far entrare.
- I blocchi temporanei rispondono 503, mai una pagina di errore con codice 200.
- Le Statistiche di scansione non mostrano cali improvvisi dopo modifiche a CDN o firewall.
- Il server di origine non è raggiungibile direttamente con il suo IP, se l’obiettivo è proteggerlo.
- La cache non serve pagine vecchie dopo un aggiornamento: verifica le regole di invalidazione.
Sono controlli da fare in un audit SEO tecnico, soprattutto dopo una migrazione o l’attivazione di una CDN. Se dopo una CDN o un firewall le pagine indicizzate sono calate, scopri cosa non va nel tuo sito: richiedi l’audit SEO.


