Canonical: cos'è il tag rel canonical e come usarlo
Capitolo 1 di 6 della guida SEO tecnica
Come si scrive, quando preferire un 301, filtri, paginazione, lingue ed errori da evitare. Verifica cosa sceglie Google.
Fondatore di SEO SRL
Pubblicato il Aggiornato l'12 min di lettura
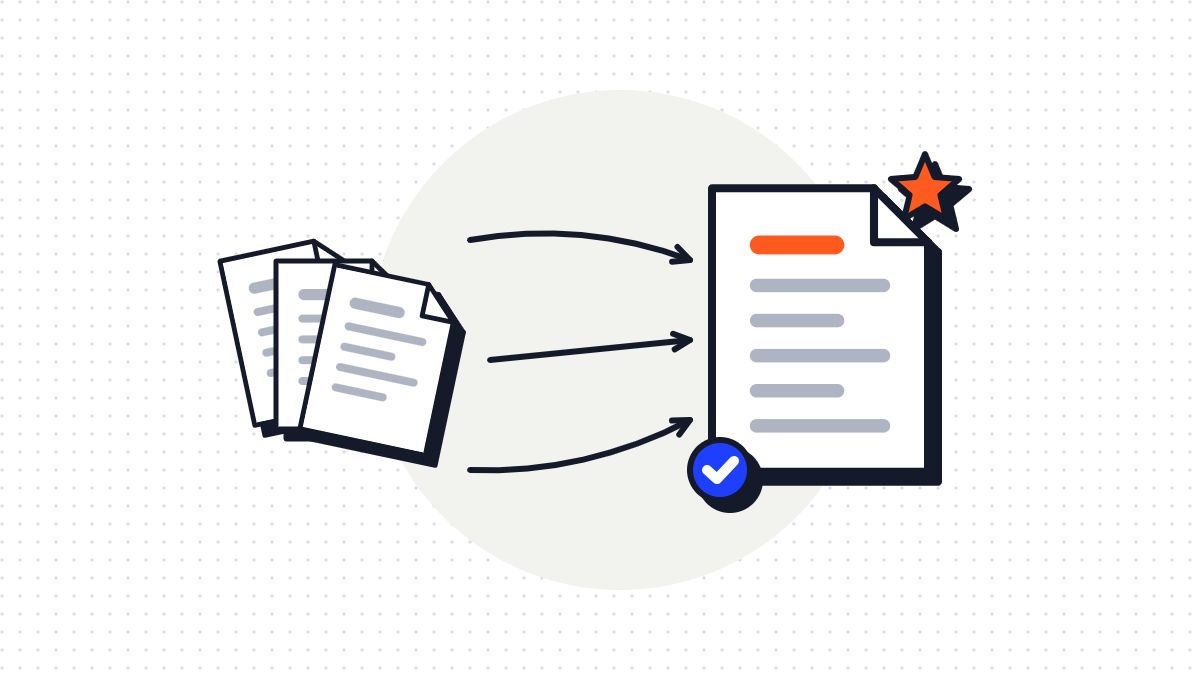
Il canonical (rel="canonical") è un tag HTML che indica ai motori di ricerca quale URL considerare principale tra più pagine con contenuto uguale o molto simile; per Google è un segnale forte, non un obbligo.
Indice dei contenuti (11 sezioni)
- Cos’è il canonical e a cosa serve
- Da dove nascono i duplicati
- Come si scrive il canonical (e dove)
- I metodi per indicare la pagina canonica
- Canonical o redirect 301?
- Casi pratici: cosa fare in ogni situazione
- Gli errori da evitare
- Come verificare se Google segue il tuo canonical
- Checklist del canonical
- Domande frequenti
- Fonti
Il canonical è un tag HTML, <link rel="canonical">, con cui indichi ai motori di ricerca quale URL considerare principale quando lo stesso contenuto, o uno molto simile, è raggiungibile da più indirizzi. Per Google è un segnale forte ma non un ordine: può scegliere un’altra pagina se gli altri segnali dicono il contrario.
È uno di quei tag che nessuno guarda finché qualcosa non va: la pagina giusta sparisce dai risultati, al suo posto compare la versione con i parametri, Search Console si riempie di “pagina duplicata”. Qui trovi come si scrive, quando usarlo al posto di un redirect, come gestire i casi difficili (filtri, varianti, paginazione, lingue) e come controllare che Google lo stia seguendo.
Cos’è il canonical e a cosa serve
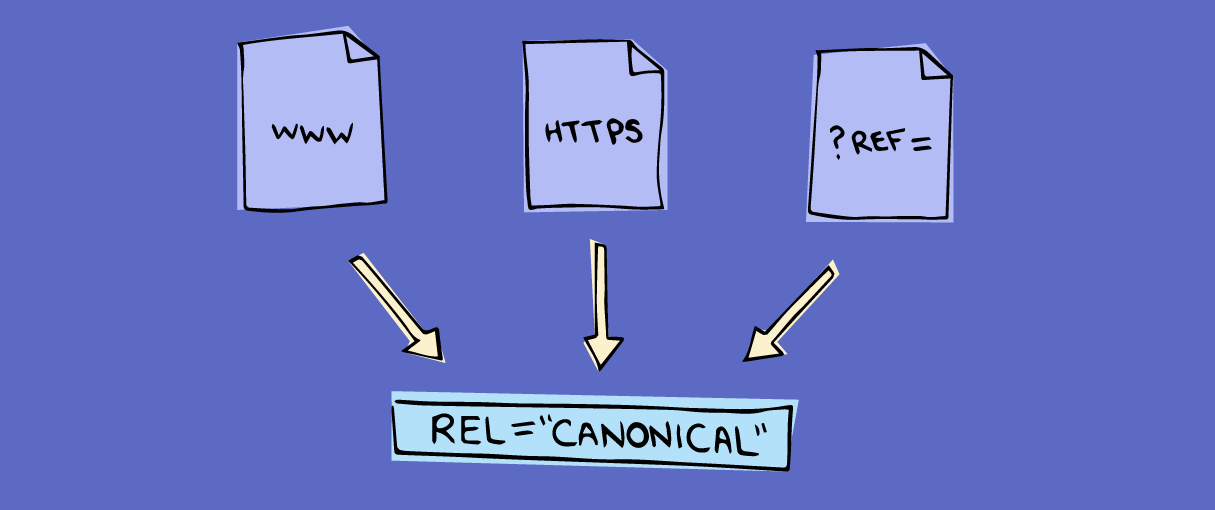
Il canonical è stato introdotto nel 2009 da Google, Yahoo e Microsoft ed è diventato uno standard nel 2012 con l’RFC 6596 dell’IETF. Si inserisce nell’head della pagina:
<head>
  <title>Vestiti verdi</title>
  <link rel="canonical" href="https://www.esempio.it/vestiti/verdi/">
</head>
Il tag dice: “di tutte le versioni di questa pagina, quella da mostrare nei risultati è questa”. Serve a tre cose concrete (Google Search Central):
- scegliere l’URL che compare nei risultati, invece di lasciarlo decidere a Google;
- concentrare i segnali (link, dati di prestazione) su un solo indirizzo, invece di dividerli tra copie;
- ridurre le scansioni inutili: Google scansiona le pagine canoniche più spesso e i duplicati meno.
Due cose che il canonical non fa. Non fa salire di posizione una pagina da solo. E non è uno scudo contro le penalizzazioni: i duplicati interni al sito sono normali e non violano le norme di Google, mentre copiare i contenuti di altri siti senza aggiungere nulla è scraping, che le norme antispam vietano, e lì nessun tag ti salva. Se il problema è quello, serve un intervento sulle penalizzazioni, non un canonical.
Da dove nascono i duplicati
Quasi mai li crea qualcuno di proposito. Li generano il CMS, il server, i filtri, gli strumenti di marketing. Una stessa scheda prodotto può rispondere a tutti questi indirizzi:
http://esempio.it/scarpe/trail-x/
https://esempio.it/scarpe/trail-x/
https://www.esempio.it/scarpe/trail-x/
https://www.esempio.it/scarpe/trail-x
https://www.esempio.it/scarpe/trail-x/?utm_source=newsletter
https://www.esempio.it/scarpe/trail-x/?colore=rosso&ordina=prezzo
https://www.esempio.it/saldi/trail-x/
Per un utente è la stessa pagina. Per un motore di ricerca sono sette URL. Google cita come cause comuni le varianti di protocollo (HTTP e HTTPS), gli ordinamenti e i filtri, le versioni per paese nella stessa lingua, le versioni mobile separate e gli ambienti di prova lasciati aperti ai crawler. Nella pratica si aggiungono il www, la barra finale e i parametri di tracciamento. Alcune si risolvono a monte con i redirect (HTTP, www, barra finale); le altre con il canonical.
Come si scrive il canonical (e dove)
Le regole sono poche, e ognuna ha una ragione.
- Solo nell’head. Google ignora un canonical nel body. E l’head deve essere valido: un’immagine o un iframe prima del canonical possono far credere a Google che l’head sia già finito (ne parlo nell’articolo sul noscript, dove è l’errore più frequente).
- URL assoluto.
https://www.esempio.it/vestiti/verdi/, non/vestiti/verdi/. I percorsi relativi sono supportati, ma basta un ambiente di prova copiato o un dominio sbagliato per farli puntare altrove. - Uno solo per pagina. Due canonical diversi (spesso uno del tema e uno del plugin SEO) si contraddicono: Google può ignorarli entrambi e decidere da sé.
- Nel codice sorgente, non aggiunto da JavaScript. Se il sito usa JavaScript, il canonical deve essere già nell’HTML e lo script non deve modificarlo.
- Anche sulla pagina canonica. Il canonical autoreferenziale, che punta alla pagina stessa, è consigliato da Google: chiude la porta alle versioni con parametri che nessuno ha previsto.
In pratica, la pagina principale e i suoi duplicati portano lo stesso tag:
<!-- in https://www.esempio.it/vestiti/verdi/?ordina=prezzo -->
<link rel="canonical" href="https://www.esempio.it/vestiti/verdi/">

<!-- in https://www.esempio.it/vestiti/verdi/ (autoreferenziale) -->
<link rel="canonical" href="https://www.esempio.it/vestiti/verdi/">
Per i file che non hanno un head, come i PDF, il canonical si invia come intestazione HTTP. Esempio: hai una guida in HTML e la stessa guida in PDF, e vuoi che nei risultati compaia la pagina HTML. Il server risponde al PDF con:
Link: <https://www.esempio.it/guida-taglie/>; rel="canonical"Su Apache si imposta nel file .htaccess:
<Files "guida-taglie.pdf">
  Header add Link "<https://www.esempio.it/guida-taglie/>; rel=\"canonical\""
</Files>
Con WordPress non serve toccare il codice: il CMS inserisce già un canonical autoreferenziale su articoli e pagine, e i plugin SEO come Yoast SEO o Rank Math permettono di cambiarlo pagina per pagina. Il rischio, semmai, è il contrario: due plugin che lo inseriscono entrambi.
I metodi per indicare la pagina canonica
Il tag non è l’unico modo. Google considera più segnali, con un peso diverso (Google Search Central):
| Metodo | Forza del segnale | Quando usarlo |
|---|---|---|
| Redirect (301, 308) | Forte | Quando il duplicato non deve più esistere: cambio di URL, HTTP→HTTPS, www, cambio dominio |
rel="canonical" nell’HTML | Forte | Quando il duplicato deve restare visibile agli utenti: filtri, ordinamenti, parametri, varianti |
rel="canonical" nell’intestazione HTTP | Forte | File non HTML, come i PDF |
| Presenza nella sitemap | Debole | Sempre, come conferma: nella sitemap vanno solo gli URL canonici |
Google pesa anche il protocollo: a parità di contenuto preferisce HTTPS a HTTP. La documentazione non cita i link interni tra i segnali, ma tenerli coerenti è buon senso: se il menu linka la versione con i parametri e il canonical punta a quella pulita, stai mandando due messaggi opposti. La regola che conta più di tutte è la coerenza: canonical, sitemap, link interni e hreflang devono indicare tutti lo stesso URL.
Canonical o redirect 301?
Entrambi consolidano i segnali su un URL, ma funzionano in modo opposto per chi visita il sito.
| Canonical | Redirect 301 | |
|---|---|---|
| Cosa vede l’utente | La pagina duplicata, che resta navigabile | Arriva direttamente al nuovo URL |
| Natura | Suggerimento: Google può non seguirlo | Istruzione del server: la vecchia pagina non c’è più |
| Funziona tra domini diversi | Sì, ma per la syndication Google oggi consiglia altro | Sì |
| Caso tipico | Filtri, ordinamenti, parametri, varianti di prodotto | Pagina spostata o eliminata, migrazione, HTTP→HTTPS |
La domanda da farsi è semplice: un utente ha motivo di vedere quella versione? Se sì, canonical. Se no, redirect. Una pagina ordinata per prezzo serve all’utente, quindi canonical. Una vecchia URL di un prodotto spostato non serve a nessuno, quindi 301. I dettagli sui redirect sono nella documentazione di Google.
Casi pratici: cosa fare in ogni situazione
Parametri di tracciamento e ordinamento
Canonical verso l’URL pulito, sempre. Nessuno cerca su Google “scarpe trail ordinate per prezzo crescente”. Meglio ancora: non linkare internamente gli URL con utm_, che servono solo per le campagne esterne.
Filtri dell’e-commerce
Qui serve una scelta, non una regola. Un filtro come “taglia 42” o “prezzo 50-100 €” di solito non ha domanda di ricerca propria: canonical verso la categoria. Un filtro come “scarpe trail impermeabili” può avere ricerche vere: allora conviene trasformarlo in una pagina indicizzabile, con URL pulito, testi propri e canonical autoreferenziale. La differenza la fa la ricerca delle parole chiave, non il CMS.
Varianti di prodotto (colore, taglia)
Se le varianti hanno pagine separate quasi identiche, canonical verso la pagina principale del prodotto. Se una variante ha una domanda propria (chi cerca proprio “sneaker rosse modello X”) e una pagina con foto e dati diversi, può restare indicizzabile con canonical autoreferenziale. Più le pagine sono simili, più è probabile che Google le consideri duplicati qualunque cosa tu dichiari.
Paginazione
Errore classico: mettere su pagina 2, 3, 4 di una categoria un canonical verso la pagina 1. Google lo sconsiglia in modo esplicito: ogni pagina della sequenza deve avere il proprio canonical, perché i prodotti di pagina 3 non sono a pagina 1 (Google, paginazione). Le pagine vanno collegate con normali link <a href>. I tag rel="next" e rel="prev" Google non li usa più.
<!-- in https://www.esempio.it/scarpe/?page=3 -->
<link rel="canonical" href="https://www.esempio.it/scarpe/?page=3">
Versioni in altre lingue o per altri paesi
Ogni versione linguistica ha il proprio canonical autoreferenziale, e le versioni si collegano tra loro con gli hreflang. Il canonical di una pagina in tedesco non deve mai puntare alla versione italiana: Google chiede che punti a una pagina nella stessa lingua. Le pagine per paesi diversi nella stessa lingua (Italia e Svizzera italiana, per esempio) sono il caso in cui Google può scegliere una sola canonica: gli hreflang servono proprio a fargli mostrare l’URL giusto a ciascun paese.
Articoli ripubblicati su altri siti
Se un tuo articolo viene ripreso da un partner, per anni la risposta è stata: canonical sul sito del partner verso l’originale. Da maggio 2023 Google non lo consiglia più per la syndication, perché le pagine dei partner spesso sono molto diverse dall’originale. La soluzione più efficace, scrive Google, è che i partner blocchino l’indicizzazione dei contenuti ripresi, per esempio con noindex (Google, risolvere i problemi di canonicalizzazione). Nella pratica non sempre riesci a ottenerlo: almeno chiedi un link visibile verso l’originale.
Gli errori da evitare
- Canonical verso una pagina che risponde con un redirect, un 404 o un noindex. Stai indicando come principale una pagina che non può esserlo.
- Canonical diverso dall’URL in sitemap o negli hreflang. Tre segnali diversi per la stessa pagina: Google sceglierà da solo.
- Canonical verso la home su tutte le pagine, per un errore del template. Succede, ed è uno dei modi più rapidi per far sparire un sito dai risultati.
- Usare robots.txt per gestire i duplicati. Se Google non può scansionare la pagina, non vede nemmeno il canonical; e gli URL bloccati possono comunque finire nell’indice senza contenuto.
- Usare il noindex per scegliere la canonica tra pagine dello stesso sito. Il noindex blocca la pagina e basta, non trasferisce nulla.
- Usare lo strumento di rimozione degli URL di Search Console: nasconde tutte le versioni, anche quella che vuoi tenere.
- Canonical con frammento (la parte dopo
#) o con la versione HTTP del sito. - Canonical su pagine diverse tra loro, per “raccogliere” i segnali su una pagina più forte. Se i contenuti non sono equivalenti, Google tende a ignorarlo, e fa bene.
Come verificare se Google segue il tuo canonical
Il canonical che dichiari e quello che Google sceglie possono essere diversi. Per saperlo:
- Codice sorgente. Apri la pagina, Ctrl+U, cerca “canonical”: ce ne deve essere uno solo, nell’head, con l’URL assoluto giusto.
- Controllo URL di Search Console. Mostra due righe: l’URL canonico dichiarato dall’utente e quello selezionato da Google. Se sono diversi, Google ha trovato segnali più forti del tuo tag.
- Report Indicizzazione delle pagine. Gli stati da conoscere sono tre: “Pagina alternativa con tag canonical appropriato” (tutto a posto, Google ha seguito il tag); “Pagina duplicata senza URL canonico selezionato dall’utente” (manca il tag, ha deciso Google); “Pagina duplicata, Google ha scelto una pagina canonica diversa da quella specificata dall’utente” (Google non ti ha seguito, da guardare).
- Crawler come Screaming Frog, sui siti grandi: estrai tutti i canonical e confrontali con gli URL in sitemap e con i link interni.
Quando Google sceglie una canonica diversa, la causa è quasi sempre una di queste: le pagine non sono davvero equivalenti, i link interni puntano all’altra versione, la sitemap elenca l’altra versione, oppure il canonical è nascosto in un head non valido. Raramente è un capriccio dell’algoritmo.
Checklist del canonical
- Ogni pagina indicizzabile ha un solo canonical, nell’head, con URL assoluto in HTTPS.
- Le pagine principali hanno il canonical autoreferenziale.
- Il canonical punta a una pagina che risponde 200, indicizzabile, nella stessa lingua.
- Canonical, sitemap, link interni e hreflang indicano lo stesso URL.
- Parametri di tracciamento e ordinamento hanno il canonical verso l’URL pulito.
- Le pagine paginate hanno ciascuna il proprio canonical.
- HTTP, www e barra finale sono gestiti con redirect, non solo con il canonical.
- In Search Console, le pagine con “Google ha scelto una pagina canonica diversa” sono poche e spiegabili.
Duplicati e canonical sono tra i primi punti di un audit SEO, soprattutto sugli e-commerce, dove i filtri moltiplicano gli URL senza che nessuno se ne accorga. Se vuoi un controllo completo, c’è il nostro audit SEO; se il problema è più ampio, parti da come indicizzare il sito.
Search Console ti segnala pagine duplicate e non sai quale versione sta mostrando Google? Richiedi l’audit SEO gratuito: ricevi le 5 cose da sistemare per prime, partendo da canonical, duplicati e indicizzazione.
Domande frequenti
Il canonical è obbligatorio?
No. Senza canonical Google sceglie da solo la versione che ritiene migliore tra le pagine duplicate. Indicarlo serve a far mostrare l'URL che preferisci e a concentrare i segnali su un solo indirizzo; per questo conviene metterlo su tutte le pagine indicizzabili.
Serve il canonical autoreferenziale?
Sì, Google lo consiglia. Una pagina che punta a sé stessa protegge dalle versioni con parametri che non hai previsto, come quelle create da campagne, filtri o strumenti esterni. La maggior parte dei CMS lo inserisce in automatico.
Meglio canonical o redirect 301?
Dipende se l'utente deve poter vedere il duplicato. Se sì, come per una pagina ordinata per prezzo, si usa il canonical. Se la pagina non deve più esistere, come in un cambio di URL o nel passaggio a HTTPS, si usa il redirect 301.
Google può ignorare il canonical?
Sì. È un suggerimento, non un obbligo. Google può scegliere un'altra canonica se le pagine non sono equivalenti, se sitemap e link interni indicano un altro URL o se il tag è in un head non valido. Lo strumento Controllo URL mostra la canonica dichiarata e quella scelta da Google.
Si può mettere un canonical verso un altro dominio?
Tecnicamente sì, e Google lo considera. Per gli articoli ripresi da siti partner, però, dal 2023 Google non lo consiglia più: suggerisce che i partner blocchino l'indicizzazione dei contenuti ripresi, per esempio con un noindex.
Come si gestisce il canonical nelle pagine paginate?
Ogni pagina della sequenza ha il proprio canonical: la pagina 3 punta a sé stessa, non alla pagina 1. Google sconsiglia esplicitamente di usare la prima pagina come canonica e non usa più i tag rel=next e rel=prev.
Fonti
- Google Search Central, “Che cos'è la canonicalizzazione degli URL”. developers.google.com/search/docs/crawling-indexing/canonicalization?hl=it
- Google Search Central, “Come specificare un URL canonico con rel="canonical" e altri metodi”, aggiornata il 15 luglio 2026. developers.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls?hl=it
- Google Search Central, “Risolvere i problemi di canonicalizzazione”. developers.google.com/search/docs/crawling-indexing/canonicalization-troubleshooting?hl=it
- Google Search Central, “Best practice per la paginazione e il caricamento incrementale delle pagine”. developers.google.com/search/docs/specialty/ecommerce/pagination-and-incremental-page-loading?hl=it
- Google Search Central, “Reindirizzamenti e la Ricerca Google”. developers.google.com/search/docs/crawling-indexing/301-redirects?hl=it
- Guida di Search Console, “Report Indicizzazione delle pagine”. support.google.com/webmasters/answer/7440203?hl=it
- Google Search Central, “Norme relative allo spam per la Ricerca Google”, sezione Scraping. developers.google.com/search/docs/essentials/spam-policies?hl=it
- Search Engine Land, “Google no longer recommends canonical tags for syndicated content”, 3 maggio 2023. searchengineland.com/google-no-longer-recommends-canonical-tags-for-syndicated-content-406491
- IETF, RFC 6596 “The Canonical Link Relation”, aprile 2012. rfc-editor.org/rfc/rfc6596
Tutte le pagine sono state aperte e verificate l’8 ottobre 2026.